Supervision des conteneurs (Kubernetes et Docker)
Un moniteur URL vous dit qu’une application est lente. Un moniteur workload vous dit pourquoi : le Deployment tourne avec 1 réplica sur 3, un pod est en CrashLoopBackOff, le conteneur a été tué pour dépassement mémoire il y a dix minutes. Mugnsoft lit ces informations directement dans l’apiserver Kubernetes ou l’API Docker Engine, depuis une sonde, sans rien installer dans le cluster.
Le modèle
La supervision des conteneurs suit le même modèle équipement avec enfants que les équipements SNMP et WMI.
| Objet | Ce que c’est | Contient |
|---|---|---|
| Hôte de conteneurs | Un cluster Kubernetes ou un hôte Docker | Runtime, endpoint, identifiants, TLS, périmètre de découverte, sondes, planning, tags |
| Workload | Un moniteur par workload adopté | Hérite de la connexion, des tags et du planning de son hôte ; une copie par sonde sélectionnée |
Un workload est identifié par ce qui survit à un déploiement, jamais par un nom de pod ou un identifiant de conteneur :
| Runtime | Identité | Exemple |
|---|---|---|
| Kubernetes | <namespace>/<kind>/<name> pour les Deployments, StatefulSets, DaemonSets et CronJobs |
prod/deployment/checkout-api |
| Docker, compose | <project>/<service>, d’après les labels com.docker.compose.* |
shop/web |
| Docker, autonome | le nom du conteneur | web-demo |
compose up. Un moniteur fondé sur eux remettrait à zéro sa chronologie et son SLA précisément au moment où l’historique est le plus utile. Fondé sur le workload, un déploiement n’est que quelques secondes de disponibilité réduite sur une série continue.
Avant de commencer
Kubernetes : un ServiceAccount en lecture seule
La sonde n’utilise que get et list. Un ClusterRole, plutôt qu’un Role limité à un namespace, permet de laisser Namespace vide et de voir tous les namespaces.
apiVersion: v1
kind: Namespace
metadata: { name: mugnsoft }
---
apiVersion: v1
kind: ServiceAccount
metadata: { name: mugnsoft-probe, namespace: mugnsoft }
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata: { name: mugnsoft-probe }
rules:
  - apiGroups: [""]
    resources: ["pods", "nodes", "namespaces", "events"]
    verbs: ["get", "list"]
  - apiGroups: ["apps"]
    resources: ["deployments", "statefulsets", "daemonsets"]
    verbs: ["get", "list"]
  - apiGroups: ["batch"]
    resources: ["cronjobs", "jobs"]
    verbs: ["get", "list"]
  - apiGroups: ["metrics.k8s.io"]
    resources: ["pods", "nodes"]
    verbs: ["get", "list"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata: { name: mugnsoft-probe }
roleRef: { apiGroup: rbac.authorization.k8s.io, kind: ClusterRole, name: mugnsoft-probe }
subjects:
  - { kind: ServiceAccount, name: mugnsoft-probe, namespace: mugnsoft }
---
# Jeton longue durée. Depuis Kubernetes 1.24, un ServiceAccount n'en reçoit plus automatiquement.
apiVersion: v1
kind: Secret
metadata:
  name: mugnsoft-probe-token
  namespace: mugnsoft
  annotations:
    kubernetes.io/service-account.name: mugnsoft-probe
type: kubernetes.io/service-account-token
Appliquez-le, puis récupérez les trois valeurs demandées par le formulaire :
kubectl apply -f mugnsoft-probe.yaml

# Endpoint
kubectl config view --minify -o jsonpath='{.clusters[0].cluster.server}'; echo
# Jeton (une ligne, sans préfixe "Bearer ")
kubectl -n mugnsoft get secret mugnsoft-probe-token -o jsonpath='{.data.token}' | base64 -d; echo
# Certificat CA (PEM)
kubectl -n mugnsoft get secret mugnsoft-probe-token -o jsonpath='{.data.ca\.crt}' | base64 -d
kubectl create token. Une sonde qui interroge le cluster de l’extérieur ne peut pas renouveler un jeton TokenRequest à expiration : le moniteur tomberait en panne à son échéance. De nombreux fournisseurs managés plafonnent aussi, sans prévenir, la durée demandée. Traitez ce jeton comme un identifiant sensible.
Docker : socket ou endpoint TLS
| Emplacement de la sonde | Connexion |
|---|---|
| Sonde Linux sur l’hôte Docker | Laissez Endpoint vide : la sonde utilise le socket local /var/run/docker.sock |
| Toute sonde, hôte distant | https://dockerhost:2376 avec le CA, le certificat client et la clé issus de la configuration TLS du daemon |
tcp:// suit la convention Docker : TLS lorsqu’un CA ou un certificat client est renseigné ou que le port est 2376, HTTP simple sinon. N’utilisez un port non chiffré que sur un réseau privé de confiance : c’est un accès root non authentifié à l’hôte.
Ou exécuter la sonde dans le cluster
Une sonde installée dans le cluster avec le chart Helm n’a besoin de rien de ce qui précède : elle utilise son propre ServiceAccount, avec le rôle en lecture seule que crée le chart. Choisissez Auth mode inCluster et laissez Endpoint vide. Voir Installer une sonde sur Kubernetes.
Ajouter un hôte de conteneurs
Ouvrez Container hosts et cliquez sur Ajouter. Le formulaire comporte quatre onglets.
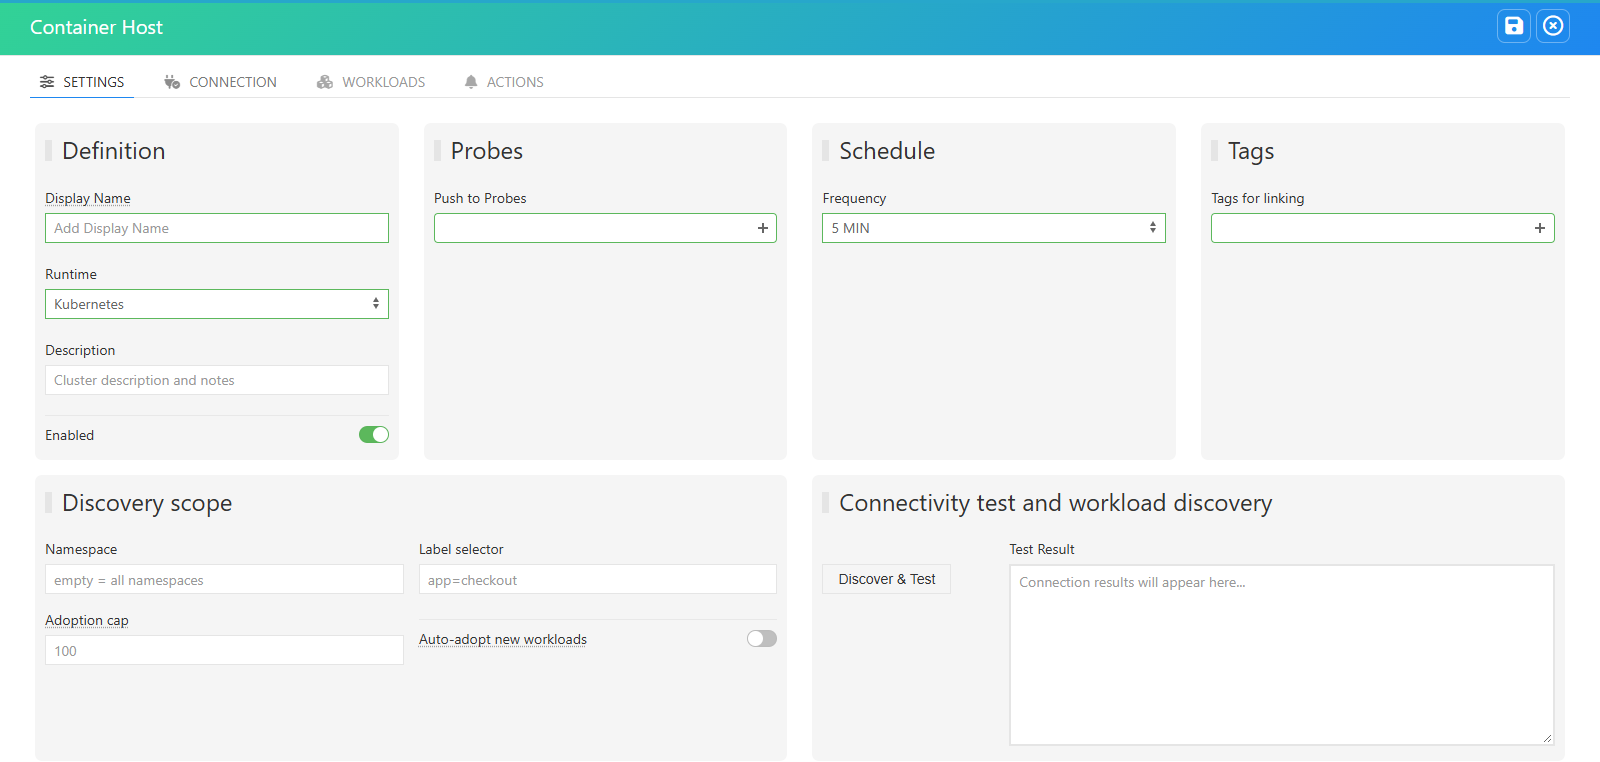
Settings
| Champ | Valeur | Remarques |
|---|---|---|
| Display Name | prod-cluster |
Nomme l’hôte dans l’interface, les rapports et les événements |
| Runtime | Kubernetes ou Docker |
Change le moteur et les champs affichés |
| Enabled | activé | |
| Push to Probes | une ou plusieurs sondes | Seuls les composants moniteur activés sont proposés. La joignabilité est testée depuis la sonde |
| Frequency | 5 MIN |
1 MIN pendant la mise en place |
| Tags for linking | shop |
Détermine l’appartenance aux applications et le périmètre des rapports ; hérité par chaque workload |
| Namespace | vide = tous les namespaces | Kubernetes uniquement. Vide exige le ClusterRole |
| Label selector | app=checkout |
Restreint la découverte |
| Adoption cap | 100 |
Nombre maximal de workloads que le réconciliateur peut proposer |
| Auto-adopt | désactivé | Voir Découverte, adoption et dérive |
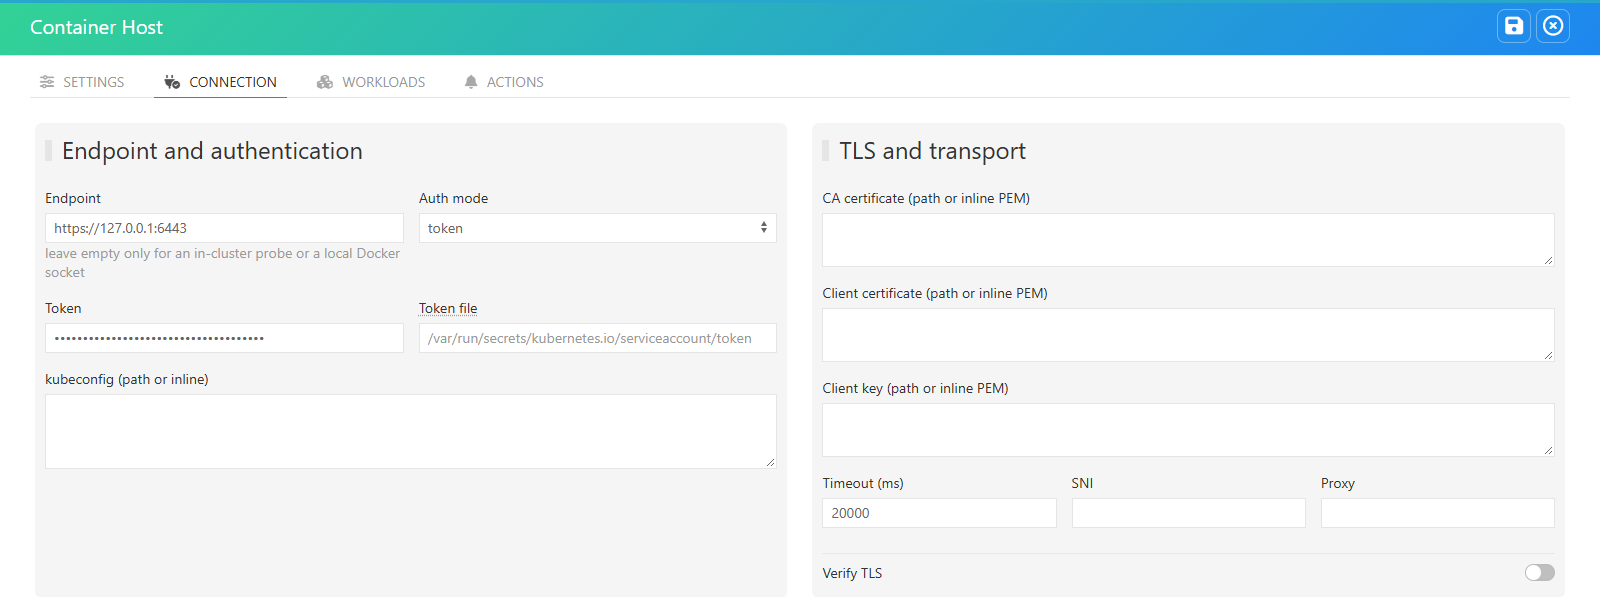
Connection
| Champ | Remarques |
|---|---|
| Endpoint | https://<apiserver>:6443, https://dockerhost:2376, ou vide pour un socket Docker local ou une sonde in-cluster |
| Auth mode | voir le tableau ci-dessous |
| Token / Token file / kubeconfig | selon le mode d’authentification |
| Docker API version / socket path | Docker uniquement ; vides, ils valent v1.43 et /var/run/docker.sock |
| CA certificate, client certificate, client key | PEM en ligne ou chemin sur la sonde |
| Timeout (ms) | 20000 par défaut |
| SNI, Proxy | optionnels ; un proxy ne s’applique jamais à un socket local |
| Verify TLS | laissez-le activé dès que vous avez le CA |
| Mode d’authentification | À utiliser pour |
|---|---|
token |
Un jeton de ServiceAccount collé en ligne — le choix habituel pour une sonde externe |
tokenFile |
Un fichier de jeton sur l’hôte de la sonde. Relu à chaque contrôle : un jeton renouvelé est pris en compte |
clientCert |
Certificat client et clé (Kubernetes ou TLS Docker) |
kubeconfig |
Un chemin ou un contenu kubeconfig dont l’utilisateur porte un jeton, un fichier de jeton ou un certificat client |
inCluster |
Une sonde qui tourne dans le cluster : le jeton, le CA et le namespace du ServiceAccount monté sont utilisés |
none |
Un socket Docker local, ou un port Docker tcp:// non authentifié |
-----BEGIN ou un saut de ligne est lue comme un PEM en ligne ; toute autre valeur est un chemin de fichier sur l’hôte de la sonde, pas sur le Webserver. Collez le CA en ligne sauf si le fichier existe réellement sur la sonde. Les chemins relatifs d’un kubeconfig sont résolus par rapport au dossier du kubeconfig lui-même, comme avec kubectl.
Workloads
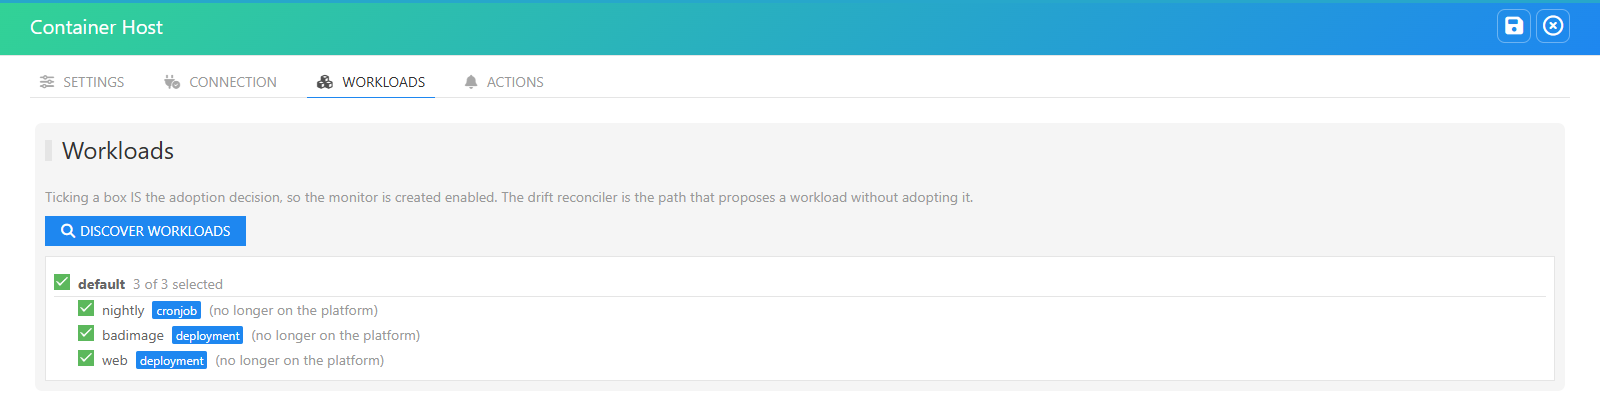
Cliquez sur Discover & Test (onglet Settings ou Workloads). Le bouton envoie le formulaire tel que saisi, pas l’enregistrement sauvegardé : il sert donc aussi de test de connexion.
OK via probe probe-01
4 workload(s) visible

  default/deployment/web            2/2 ready
  kube-system/deployment/coredns    2/2 ready
  kube-system/daemonset/kube-proxy  3/3 ready
  default/statefulset/pg            1/1 ready
Une ligne ERROR donne la raison : endpoint injoignable, jeton refusé, RBAC manquant, CA inconnu. Une liste vide sous OK signifie que le périmètre ne correspond à rien.
La liste est regroupée par namespace ou projet compose, les conteneurs autonomes en dernier ; la case d’un groupe coche tous ses workloads.
Cocher un workload, c’est décider de l’adopter : son moniteur est créé activé sur chaque sonde sélectionnée à l’enregistrement.
Actions
Les mêmes paramètres de notification qu’un équipement SNMP, appliqués à chaque workload de l’hôte :
| Bloc | Champs |
|---|---|
| Notification settings | Destinataires email, canal et jeton Slack, webhook Teams, clé d’API PagerDuty, script personnalisé et son timeout |
| Notify after | if worse or equal to un statut, and after x checks, for x checks (0 = illimité), et un interrupteur par canal |
| Notify on status change | Un interrupteur par canal |
Enregistrer l’hôte pousse ces paramètres vers tous ses workloads : une seule modification atteint chaque moniteur workload. Sans Integrator, la sonde envoie elle-même les notifications ; avec un Integrator, c’est lui qui s’en charge. L’email exige que le paramétrage SMTP ait été validé.
Découverte, adoption et dérive
- Ce qui est proposé. Kubernetes : Deployments, StatefulSets, DaemonSets et CronJobs. Les Jobs ne sont pas proposés, car les CronJobs les créent et les suppriment en permanence ; le CronJob lui-même l’est. Docker : conteneurs et services compose. Les conteneurs ponctuels
docker compose runsont ignorés. - Auto-adopt. Toutes les 10 minutes, le Webserver relance la découverte de chaque hôte dont Auto-adopt est activé :
- un nouveau workload est proposé, jamais adopté : son moniteur est créé désactivé, dans la limite de l’adoption cap ;
- un workload disparu est marqué « gone » et son moniteur désactivé. Il n’est jamais supprimé, son historique reste consultable, et il conserve votre décision d’adoption s’il revient.
- Une réponse partielle ne retire jamais rien. Si la découverte a été interrompue (un type que le jeton ne peut pas lister, un timeout, un très gros cluster), rien n’est marqué disparu.
- Supprimer un hôte de conteneurs conserve ses moniteurs workload et leur historique. Les retirer est une action explicite sur chaque moniteur.
Évaluation d’un workload
L’échelle de gravité
ERROR se classe au-dessus de CRITICAL, et c’est voulu : « je n’ai pas pu regarder » ne doit jamais se lire « j’ai regardé et tout va bien », et doit rester distinct de « j’ai regardé et c’est mauvais ».
| Statut | Déclenché quand |
|---|---|
| ERROR | L’API est injoignable, refuse les identifiants, n’accorde pas la permission, ou le workload n’existe plus |
| CRITICAL | Aucun réplica prêt, ou une faute franche : CrashLoopBackOff, ImagePullBackOff, un OOM kill depuis le contrôle précédent, une éviction, des pods non planifiables, un healthcheck en échec, une erreur de configuration de conteneur, un conteneur arrêté, une exécution de CronJob ou de Job en échec |
| MAJOR | Mise à l’échelle à zéro (sauf si zéro réplica est autorisé), un déploiement qui a dépassé son délai de progression, des réplicas impossibles à créer |
| MINOR | Certains réplicas ne sont pas prêts |
| OK | Tous les réplicas sont prêts et aucune faute |
Les règles
| Règle | Comportement |
|---|---|
| Disponibilité | Réplicas prêts face aux réplicas désirés. Par défaut, tout manque est MINOR et zéro réplica prêt est CRITICAL. Les pods en cours d’arrêt sont ignorés : une mise à jour progressive ne fait pas osciller le statut |
| CronJob et Job | Évalués sur la dernière exécution, jamais sur des réplicas : rien d’actif entre deux exécutions est OK, une exécution en échec est CRITICAL |
| Fautes franches | Chacune est activée par défaut. Un arrêt passé ne compte que s’il est survenu depuis le contrôle précédent : un OOM kill de la semaine dernière ne maintient pas le workload en rouge. Sur Docker, un redémarrage efface l’état du conteneur : les OOM kills et plantages depuis le contrôle précédent sont donc aussi lus dans le journal d’événements du daemon, et trois sorties en échec dans cette fenêtre valent une boucle de plantage |
| Delta de redémarrages | Redémarrages depuis le contrôle précédent. Évalué uniquement si des seuils sont définis ; le premier contrôle n’a pas de référence et reste silencieux |
| CPU / mémoire en % de la limite, throttling CPU en % | Évalués uniquement si des seuils sont définis, et seulement quand chaque conteneur a une limite |
Métriques
Chaque contrôle enregistre sept groupes, présentés un panneau par groupe dans le rapport du workload. Chaque clé est écrite à chaque contrôle, à zéro lorsque le runtime n’a pas d’équivalent : un conteneur Docker remonte ainsi les compteurs de phases de pods à 0 plutôt que de laisser des trous dans les séries.
| Groupe | Métriques |
|---|---|
| A Disponibilité | Réplicas désirés, prêts, disponibles et indisponibles, conteneurs en cours, uptime (réplica le plus ancien) |
| R Redémarrages et fautes | Nombre et delta de redémarrages, OOM kills, pods en boucle de crash, erreurs de récupération d’image, dernier code de sortie |
| C CPU | Millicores, % de la limite, % de la demande, % de throttling, secondes de throttling |
| M Mémoire | Octets, % de la limite, % de la demande, working set, RSS, cache |
| N Réseau et E/S | Octets reçus et envoyés, lectures et écritures bloc |
| P Phases des pods (Kubernetes) | Running, pending, failed, succeeded, evicted, non prêts |
| E Erreurs de contrôle | Erreurs d’API, timeouts, échecs d’authentification, métriques indisponibles, échecs de sonde |
Le temps de réponse tracé pour un workload est la latence de l’API pendant le contrôle, pas celle de l’application.
Où apparaissent les résultats
| Emplacement | Ce que vous obtenez |
|---|---|
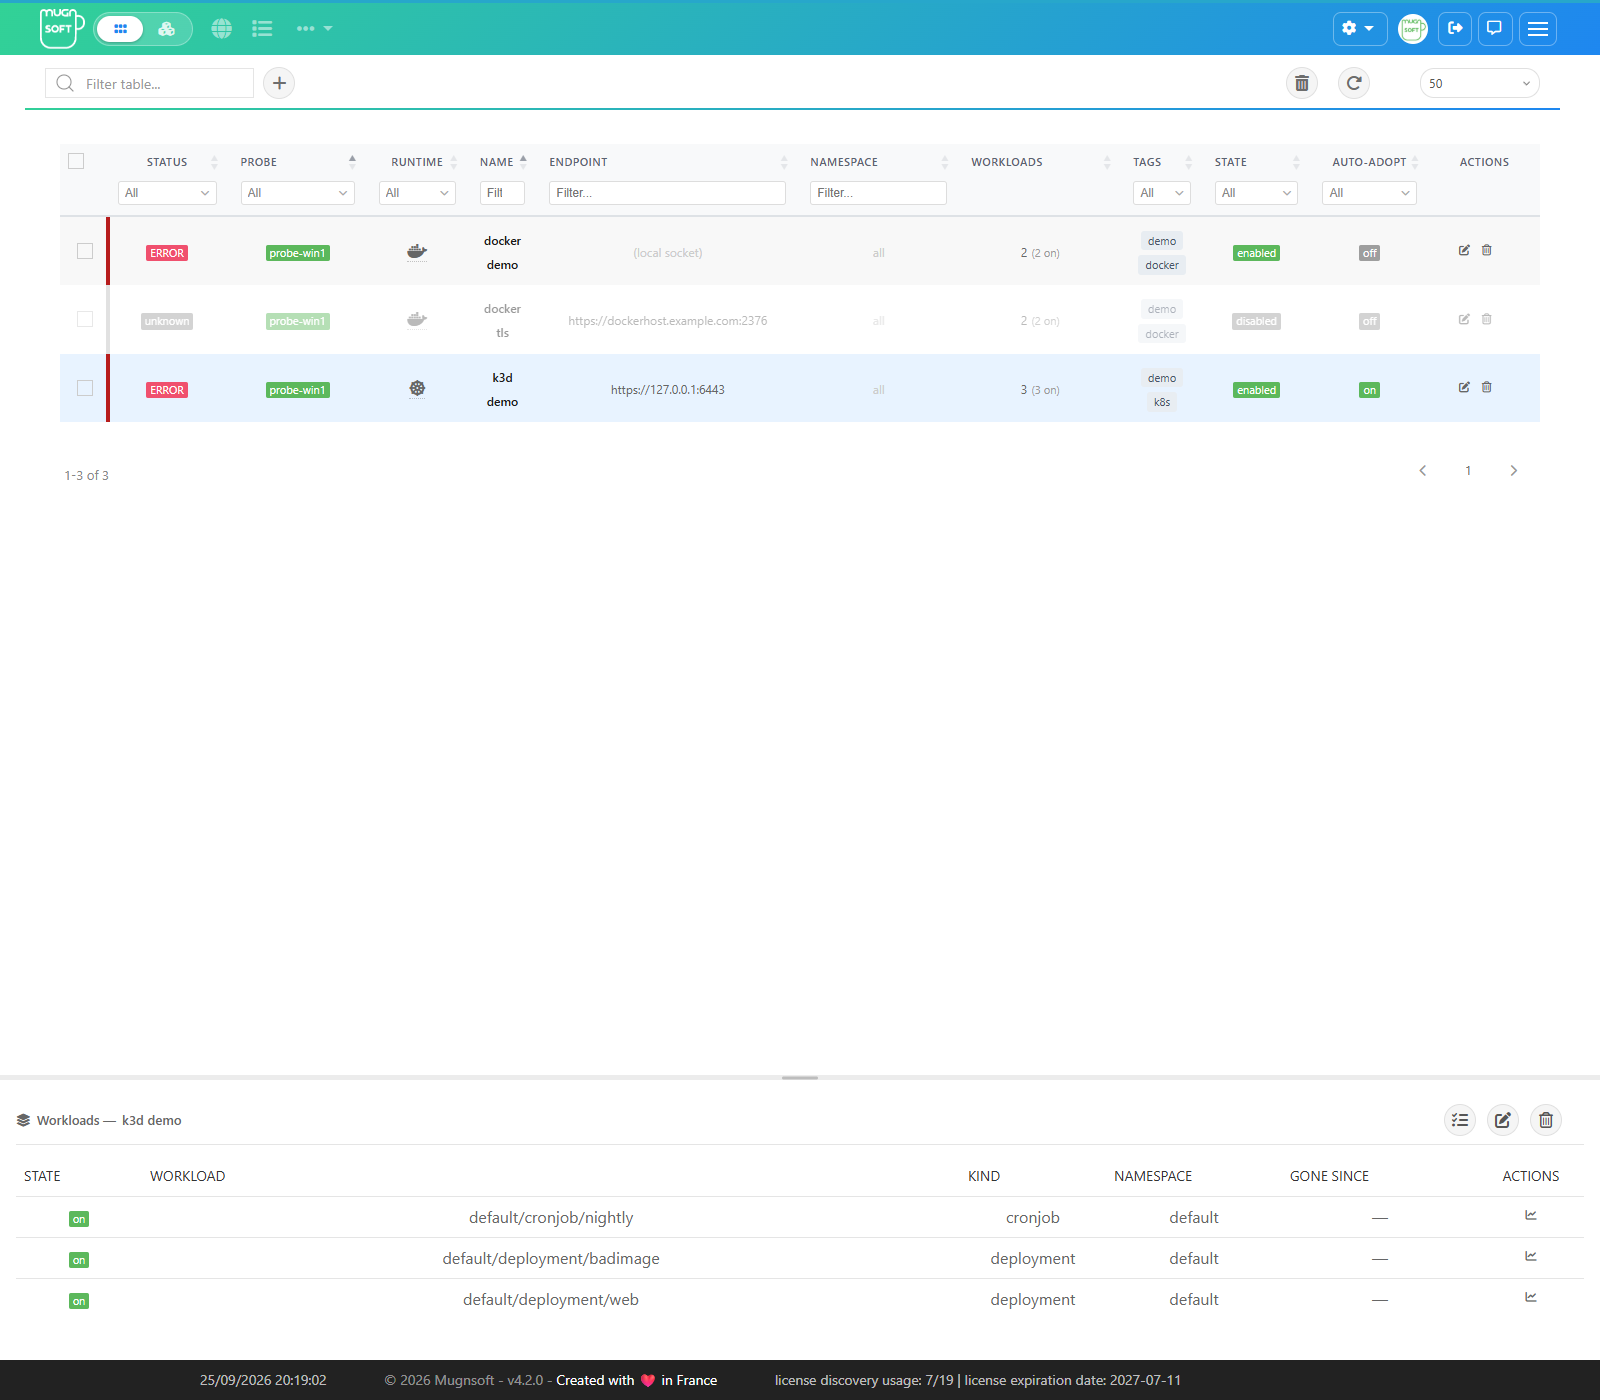
| Page Container hosts | Une ligne par hôte avec un statut consolidé. Le panneau de détail liste les workloads (on / proposed / gone) avec un bouton de rapport pour chacun |
| Page All | Tous les moniteurs workload, avec les filtres, le rapport et les actions habituels |
| Rapport de workload | Chronologie des statuts, répartition des statuts, temps de réponse de l’API et les sept panneaux de métriques ; disponible aussi en rapport planifié |
| Applications | Les workloads rejoignent les applications par leurs tags ; la règle métier pondérée comporte un poids Container host |
| Notifications | Email, Slack, Teams, PagerDuty et script personnalisé, réglés une fois dans l’onglet Actions de l’hôte |
| Integrator | Chaque résultat de workload : sorties séries temporelles et fichiers journaux, tickets ServiceNow / GLPI / Jira au changement de statut, corrélation des causes racines |
| Webserver-front | L’équipement hôte de conteneurs et son statut sont répliqués |
Le statut propre de l’hôte de conteneurs combine quatre signaux indépendants, parce qu’ils tombent en panne indépendamment : l’endpoint est joignable, l’API répond sainement (/readyz ou /_ping), la pire condition de nœud (Kubernetes uniquement) et le pire workload. Un jeton expiré se lit donc comme un problème d’API plutôt que comme un cluster en panne. Côté nœuds, une pression mémoire, disque ou PID est MINOR, un nœud NotReady MAJOR, aucun nœud prêt CRITICAL, et un nœud cordonné ne relève jamais la gravité : un drainage de maintenance ne réveille personne.
Limites
| Limite | Que faire |
|---|---|
| Les seuils par workload ne sont pas modifiables dans l’interface. Disponibilité et fautes tournent sur leurs valeurs par défaut ; les échelles redémarrages, CPU, mémoire et throttling restent vides | S’appuyer sur les valeurs par défaut. Les valeurs posées sur un workload via l’API de la sonde sont conservées au réenregistrement de l’hôte |
| La santé des nœuds n’alerte jamais. Elle colore l’hôte de conteneurs, mais aucun nœud NotReady ou sous pression ne déclenche d’alerte | Superviser les nœuds comme des hôtes avec Ping, Système ou le Sentinel Agent |
| Le statut de l’hôte de conteneurs n’est pas envoyé à l’Integrator, comme pour les équipements SNMP et WMI | Rien n’est perdu : une API injoignable met chaque workload en ERROR, et chacun est envoyé |
| Pas de socket Docker local sur les sondes Windows | Utiliser un endpoint tcp:// / https://, ou une sonde Linux |
| Les kubeconfig de clusters managés (EKS, GKE, AKS) s’authentifient par des plugins exec ou auth-provider que la sonde ne peut pas exécuter ; ils sont refusés avec une erreur explicite | Utiliser un jeton de ServiceAccount. Le insecure-skip-tls-verify d’un kubeconfig est aussi ignoré : c’est l’interrupteur Verify TLS qui décide |
| Sans metrics-server, les panneaux CPU et mémoire restent à zéro, avec métriques indisponibles positionné | Installer metrics-server (fourni par les clusters managés et k3d, pas par kind) |
| Les Jobs ne peuvent pas être adoptés | Adopter le CronJob qui les crée |
| La découverte est bornée : un Discover & Test liste au plus 500 workloads | La restreindre par namespace ou sélecteur de labels |
| Ce n’est pas une base de métriques. Un échantillon par contrôle, à l’intervalle du moniteur, conservé selon la rétention habituelle | Garder Prometheus ou votre plateforme d’observabilité pour l’historique à forte cardinalité |
| Les workloads ne s’importent pas seuls | Importez ou exportez l’hôte de conteneurs : sa ligne porte la sélection de workloads et recrée leurs moniteurs |
| Écart de versions. Sonde, Webserver et Integrator doivent tous connaître les types conteneurs | Les mettre à jour ensemble : un Integrator ancien rejette les résultats workload, une sonde ancienne n’a pas de moteur workload |
Dépannage
| Symptôme | Cause probable |
|---|---|
ERROR sur Discover & Test, connection refused ou timeout |
L’endpoint n’est pas joignable depuis la sonde — pare-feu, liste d’autorisation CIDR de l’apiserver, proxy |
ERROR, 401 / authentication |
Jeton erroné ou expiré, ou préfixe Bearer collé avec |
ERROR, 403 / forbidden |
Il manque au ServiceAccount une permission du ClusterRole ci-dessus |
ERROR, certificate |
CA absent ou chemin de fichier inexistant sur la sonde — collez-le en ligne |
Liste vide sous OK |
Namespace ou sélecteur de labels sans correspondance, ou Role limité à un namespace avec Namespace vide |
| CPU et mémoire restent à 0 | Pas de metrics-server, ou pas de limites — les pourcentages exigent une limite sur chaque conteneur |
| Un CronJob reste OK alors que ses jobs échouent | L’exécution en échec n’a pas encore épuisé ses tentatives ; il passe CRITICAL dès que le Job est marqué Failed |
| Un workload Docker indique restart and OOM events unavailable | Le daemon a refusé son journal /events — typiquement un proxy de socket qui le bloque. Le contrôle évalue toujours ce que montre l’état du conteneur, mais manque les OOM kills et plantages qu’un redémarrage a déjà masqués |
Voir aussi
- Types de moniteurs — le catalogue de tous les types
- Composant Moniteur en détail — stockage, moteur et endpoints
- Integrator — sorties, ITSM et modèle causal, dont
workload - Évaluation SNMP et WMI — les autres types équipement avec enfants
- Comment fonctionnent les seuils — modèle de gravité et calcul du statut