ON FAIL et ON CHANGE
Chaque canal a deux declencheurs. ON FAIL alerte tant qu’un moniteur reste dans un mauvais statut. ON CHANGE alerte chaque fois que son statut change. Ils sont independants : activez l’un, l’autre, ou les deux.
La regle ON FAIL
La regle est la barre en haut de l’onglet Actions du moniteur. Elle est commune a tous les canaux dont l’interrupteur On fail est actif.

| Champ | Valeurs | Defaut | Signification |
|---|---|---|---|
| notify if status is … or worse | minor, major, critical, error | critical | Le statut le plus bas qui compte comme un echec. |
| after x checks | 1 a 10 | 3 | Combien de controles precedents doivent aussi avoir echoue. |
| for x checks | 0 a 100 (0 = illimite) | 0 | Combien d’alertes envoyer pour un meme episode d’echec. |
Quels statuts comptent
Les statuts sont classes du meilleur au pire. Un controle compte comme echoue quand son statut est au niveau choisi ou au-dessus :
| Rang | Statuts |
|---|---|
| 0 | OK, UNKNOWN |
| 1 | MINOR |
| 2 | MAJOR |
| 3 | CRITICAL |
| 4 | ERROR, TIMEOUT, EXCEPTION, CONFIG |
Ainsi critical ou pire se declenche aussi sur ERROR, TIMEOUT, EXCEPTION et CONFIG, et error sur ces quatre statuts. Des mauvais statuts differents a la suite forment une seule serie d’echecs : MAJOR, CRITICAL, MAJOR font trois controles en echec pour une regle major ou pire.
Quand il se declenche
Apres chaque controle, la sonde examine ce controle et les x controles qui le precedent (x = after x checks). S’ils ont tous echoue, l’alerte part. Autrement dit, avec after x checks = x, la premiere alerte part au (x+1)e controle en echec consecutif : avec la valeur par defaut 3, au 4e.
Echecs repetes
Tant que le moniteur reste en echec, la regle est reevaluee a chaque controle :
- for 0 checks (defaut) : une alerte a chaque controle, aussi longtemps que dure l’echec. Avec une planification d’une minute, une alerte par minute.
- for N checks : N alertes, sur N controles consecutifs, puis silence jusqu’au retour a la normale.
Retour a la normale
ON FAIL n’envoie jamais rien quand un moniteur se retablit : un controle OK ne satisfait pas la regle. Il remet en revanche le compteur a zero : l’echec suivant ouvre un nouvel episode, attend de nouveau after x checks et renvoie jusqu’a for x checks alertes.
Pour etre prevenu du retablissement, activez aussi On change. Deux exceptions : PagerDuty et SIGNL4. Quand leur declencheur On fail est actif, le retablissement envoie quand meme un resolve : l’incident ou l’alerte ouvert par ON FAIL est ferme meme avec On change inactif (voir PagerDuty et SIGNL4).
Un exemple complet
Regle : critical ou pire, after 1 check, for 3 checks, planification toutes les minutes.
| Controle | Statut | Echecs consecutifs | ON FAIL | ON CHANGE |
|---|---|---|---|---|
| 10:00 | OK | 0 | - | - |
| 10:01 | CRITICAL | 1 | - (il en faut 2) | envoye (OK → CRITICAL) |
| 10:02 | CRITICAL | 2 | envoye (1re) | - |
| 10:03 | ERROR | 3 | envoye (2e) | envoye (CRITICAL → ERROR) |
| 10:04 | ERROR | 4 | envoye (3e) | - |
| 10:05 | ERROR | 5 | - (3 envoyees) | - |
| 10:06 | OK | 0 | - | envoye (ERROR → OK, “RESOLVED”) |
| 10:07 | CRITICAL | 1 | - (nouvel episode) | envoye |
Avec for 0 checks, ON FAIL se serait aussi declenche a 10:05 et a chaque controle en echec suivant.
Le declencheur ON CHANGE
ON CHANGE alerte a chaque changement de statut, quelle que soit sa severite : OK → MINOR, MAJOR → CRITICAL, CRITICAL → OK… La regle ON FAIL (niveau, after, for) ne s’y applique pas. Une alerte de retablissement s’intitule [RESOLVED] <moniteur> is back to OK. Le premier statut d’un nouveau moniteur n’est pas un changement : ON CHANGE commence a son deuxieme statut.
Anti-rebond (debounce)
Un moniteur qui oscille (un timeout, puis OK) produit deux changements, donc deux alertes ON CHANGE. Le parametre de sonde Debounce status-change alerts retient un changement jusqu’a ce que le nouveau statut ait dure after x checks + 1 controles consecutifs (x vient de la regle ON FAIL de chaque moniteur). Un changement qui ne dure pas aussi longtemps n’est jamais notifie ; un changement qui dure est notifie au controle ou il devient stable.
Ouvrez le menu engrenage → components, clic droit sur la sonde, edit server, bloc Auto baselining :
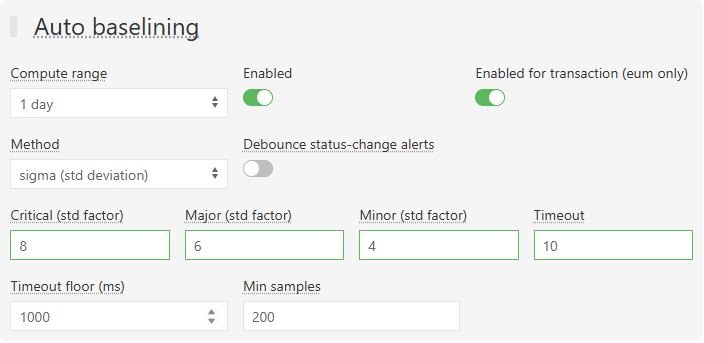
L’anti-rebond s’applique a tous les moniteurs de la sonde, et uniquement aux notifications : le statut, les rapports et les tickets ITSM (ServiceNow, GLPI, Jira) suivent toujours chaque changement.
Choisir les declencheurs
| Vous voulez | On fail | On change | Regle |
|---|---|---|---|
| Etre alerte quand un service est tombe, pas a chaque micro-coupure | actif | inactif | error, after 2-3, for 1 |
| Un rappel tant qu’il reste tombe | actif | inactif | after 3, for 0 (chaque controle) ou for N |
| Savoir quand cela commence et quand cela finit | inactif | actif | - (activez l’anti-rebond contre les oscillations) |
| Un outil d’incidents qui ouvre et ferme les incidents (PagerDuty, SIGNL4) | actif | optionnel | le retablissement resout l’incident dans les deux cas |
| Un script de remediation lance une fois par incident | actif | inactif | after x, for 1 |
Chaque declencheur doit etre active deux fois
Un declencheur ne fonctionne que s’il est actif sur le moniteur et sur son Integrator (Integrator → Notifications). L’interrupteur de l’Integrator est partage par tous les moniteurs qui passent par lui : desactiver On change la-bas coupe ON CHANGE pour tous. Voir Comment une alerte arrive jusqu’a quelqu’un.
Voir aussi
- Seuils : comment une mesure devient MINOR, MAJOR ou CRITICAL.
- Operations sur les arrets programmes : faire taire les alertes pendant une intervention planifiee.
- Depannage : quand une alerte attendue n’arrive pas.